Le planificateur accepte désormais les requêtes en anglais. Les modules, eux, continuent de se disputer en chiffres.
Un nouveau framework publié sur arXiv route des exigences de planification exprimées en langage courant à travers trois modules d'entrepôt couplés, puis évalue les résultats. Les changements corrects mais qui ne parviennent pas à faire bouger la métrique visée constituent désormais l'échec dominant, et personne dans l'architecture ne possède l'exigence qui en est à l'origine.
Admiral Neritus Vale
Le problème difficile de la planification retail ne consiste plus à résoudre le modèle, mais à formuler ce que l’on veut, et un article publié sur arXiv le 3 septembre chiffre cet écart. Ses auteurs ont placé une couche en langage naturel au-dessus d’un pipeline d’entrepôt chez un grand partenaire retail, puis ont noté chaque instruction deux fois : une première fois pour vérifier si le changement obtenu était légal, exécutable et appliqué au module visé, une seconde fois pour vérifier s’il améliorait la métrique que l’exigence était censée faire bouger. Les taux de correction sont restés élevés sur les trois modèles de base testés, entre 89 et 96 %. Ce chiffre ne dit que si un changement était valide, pas s’il a fonctionné. Le succès de bout en bout — le fait que le changement ait effectivement fait bouger la métrique visée — est passé d’une base de 72–76 % à 79–83 % avec ce framework, et l’écart entre ces deux questions, c’est la spécification : la partie de la requête que personne n’a fini d’écrire, et que personne, dans cette architecture, ne possède.
Cette conception admet ce qu’une simple boîte de texte ne peut pas faire seule. Les travaux précédents dirigeaient les modèles de langage vers un unique modèle d’optimisation ; cet entrepôt en fait tourner trois, couplés entre eux, couvrant le prétraitement, l’emballage et l’expédition, où une modification en amont change les entrées et les décisions possibles en aval. Chaque module publie donc ce que les auteurs appellent des interfaces de reformulation admissibles, un menu fixe de modifications qu’il accepte, et un processeur central explore des chemins bornés à travers ce graphe plutôt que de laisser le modèle écrire ce qu’il veut. Les candidats survivants sont exécutés et comparés sur les KPI en aval. La couche linguistique reçoit la requête ; le graphe décide quel module a le droit d’y répondre.
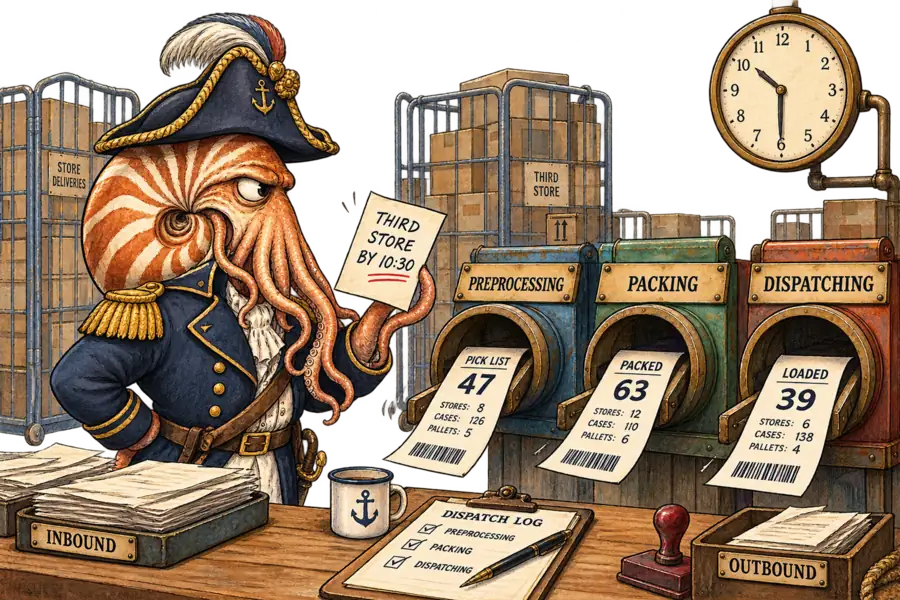
Une exigence de l’étude montre pourquoi le routage n’est pas une simple formalité administrative. Elle se lit ainsi : « Terminer le processus d’emballage et d’expédition du troisième magasin avant 10h30, l’entrepôt commençant son traitement à 8h00. » La phrase nomme un résultat, pas un mécanisme. Trois modules peuvent chacun le produire : réordonner l’expédition, reconstruire les unités de charge pour que les cages du troisième magasin soient prêtes plus tôt, ou modifier ce que le prétraitement transmet en aval. La formulation même des auteurs résume la situation au mieux : « plusieurs reformulations localement valides peuvent satisfaire l’exigence tout en menant à des résultats différents au niveau du système après ré-exécution en aval ».
Une exigence à laquelle trois réponses légales sont possibles n’est pas une requête ; c’est une décision inachevée, remise au premier module que le routeur atteint.
La répartition par niveau de difficulté dans l’étude montre où l’orchestration justifie son coût, et ce n’est pas là où se déroulent les démonstrations. Sur les exigences à intervention évidente unique, le routage par le graphe a obtenu un score légèrement inférieur à celui d’une requête directe au modèle, ce qui est généralement le résultat quand on ajoute de la machinerie à un problème qui n’en avait pas besoin. Là où plusieurs modifications plausibles étaient en concurrence, le succès de bout en bout est passé de 54 % à 72 % avec DeepSeek comme modèle de base. Le dispositif existe pour absorber le sous-spécifié, et il ne vaut la dépense que lorsque la requête était sous-spécifiée dès le départ.

Le garde-fou installé par les auteurs est l’endroit où la responsabilité devient littérale. Leur règle de tolérance est qu’« aucun KPI système surveillé ne peut se dégrader de plus de 10 % », et lorsqu’aucun candidat ne passe la validation, le framework « laisse la configuration inchangée et rapporte les diagnostics collectés ». C’est de l’ingénierie soignée, et cela délimite aussi la responsabilité du système autour des métriques que quelqu’un a déjà pensé à instrumenter. Une exigence mal spécifiée se paie donc au-delà de cette frontière : dans le KPI que personne ne surveillait, lors d’une revue que personne n’avait programmée.
Les dépenses arrivent plus vite que ne se pose la question de la responsabilité. Gartner prévoit que les dépenses en logiciels de gestion de la chaîne d’approvisionnement dotés d’IA agentique passeront de moins de 2 milliards de dollars en 2025 à 53 milliards de dollars en 2030, une prévision republiée par IT Supply Chain, et le conseil que Gartner donne aux acheteurs dans cette même prévision est de maintenir « des niveaux appropriés d’humain dans la boucle pour les décisions de gestion de la chaîne d’approvisionnement » — de la supervision, pas de la rédaction. Ses tendances technologiques distinctes pour la chaîne d’approvisionnement en 2026, répertoriées par Inside Logistics, désignent la gouvernance des décisions comme une tendance à part entière, classée sous « confiance et gouvernance » plutôt que sous le thème « autonomie et agentivité » qui abrite l’IA agentique et les systèmes multi-agents collaboratifs. Nommer la tendance n’équivaut pas à en attribuer la responsabilité.
L’objection la plus solide est qu’il s’agit d’un benchmark, pas d’une opération réelle. Cent exigences recueillies chez un seul partenaire non identifié et notées par le propre système de KPI des auteurs, c’est un résultat de laboratoire ; si les exigences univoques dominent les files d’attente réelles de planification, une interface en langage naturel n’est qu’un confort, le routage ambigu reste un cas marginal, et la spécification ne devient jamais un point de charge critique. C’est la condition dont dépend cet argument, et l’habillement est la catégorie la moins susceptible de la remplir. Un ordre de réassort placé contre six semaines de ventes réelles, une réaffectation entre clusters de magasins, une démarque avancée : chacun arrive comme un objectif offrant plusieurs voies légales à travers l’emballage, l’allocation et l’expédition, sans qu’aucune ne dise au système quelle voie prendre. Le groupe le plus difficile de l’étude existe précisément parce que les praticiens ont produit ces exigences lorsqu’on leur a demandé ce qu’ils envoient réellement.
Un framework rival publié en avril répond à la question de la responsabilité en désignant une personne, ce qui montre à quel point cette désignation règle peu de choses. Flowr, conçu avec une grande chaîne de supermarchés, place les gestionnaires de la chaîne d’approvisionnement dans une boucle d’orchestration où ils « supervisent et interviennent à chaque étape du workflow », ce qui préserverait, selon ses auteurs, « la responsabilité et le contrôle organisationnel ». La supervision, c’est un droit de veto sur des étapes déjà proposées. La défaillance mesurée dans l’étude sur l’entrepôt se produit plus tôt que cela, au moment où une phrase à trois lectures légales entre dans un système conçu pour en choisir une et passer à la suite.
Les retailers qui achètent une couche linguistique pour leur planification achètent un service de traduction, et un service de traduction a besoin d’un éditeur. L’étude porte sur l’emballage et l’expédition en entrepôt plutôt que sur l’allocation dans l’habillement, et son partenaire reste anonyme, mais la structure se retrouve partout où des modules couplés se voient rehabillés d’une fenêtre de chat : le système fera ce que la phrase a dit, et cette phrase est désormais écrite par quiconque se trouve au clavier. Si les changements d’exigences restent rares et sans ambiguïté, la spécification peut continuer d’être l’affaire de tout le monde et de personne. S’ils arrivent au rythme où l’habillement change d’avis, le poste qui vaut la dépense n’est pas un meilleur prévisionniste mais un responsable nommé pour l’exigence, et le moment le moins coûteux pour inscrire ce rôle dans le processus, c’est avant que le premier KPI non instrumenté ne bouge.