Le Cache Décide Quelles Questions un Assistant Retail Peut se Permettre
La mise en cache des prompts ne se rentabilise que si la même question revient, et un article de recherche sur le semantic caching illustre des taux de succès de 40 à 60 % pour les catégories de requêtes répétitives, contre 5 à 15 % pour les requêtes rares. Cette arithmétique rend les questions sur le catalogue peu coûteuses, et fait du styling sur mesure — celui que chaque fournisseur met en avant dans ses démos — la chose la plus coûteuse qu'on puisse demander à un assistant.
Neritus Vale
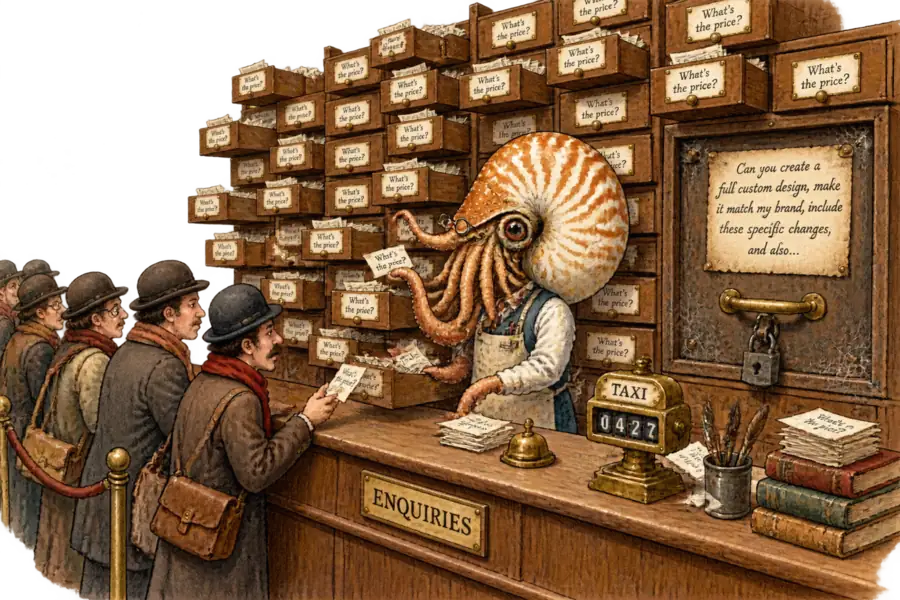
Chaque assistant IA retail est tarifé sur un pari : que les clients se répètent. Lire un prompt mis en cache coûte un dixième du tarif normal en entrée, selon la grille tarifaire publiée par Anthropic. Écrire dans ce cache coûte 25 % de plus que de ne pas le faire du tout, pour le cache standard de cinq minutes ; l’option d’une heure coûte le double. La remise est un prêt qui ne s’éteint que si le même prompt revient — et deux fois plus vite s’il faut rembourser sur l’horloge la plus longue. Le shopping conversationnel sort des phases pilotes pour entrer en production sur la foi de ce pari. Il tient beaucoup mieux pour les questions sur le catalogue que pour les questions sur le client.
Les taux de répétition varient énormément selon le type de question posée. Un article de position de 2025 sur le semantic caching sensible aux catégories illustre cette arithmétique à partir d’une charge de production représentative : des taux de succès de 40 à 60 % pour les catégories de requêtes fortement répétitives. C’est le haut de la fourchette que l’article utilise pour étayer son propos, pas un chiffre qu’il dit avoir mesuré. Les catégories rares ou volatiles se situent en bas, entre 5 et 15 %, ce qui marque l’écart entre un cache qui rentabilise l’infrastructure qui l’entoure et un cache qui ne la rentabilise pas. Le matériau étudié était du code et des conversations plutôt que du shopping, l’analogie doit donc être établie plutôt que présumée. La propriété qui fait le travail se transpose proprement : les questions à gabarit se regroupent et se répètent, les questions ouvertes se dispersent.
En dessous d’un certain taux de succès, mettre une question en cache coûte plus cher que d’y répondre à froid. La même charge illustrative situe le seuil de rentabilité d’un cache vectoriel conventionnel entre 15 et 20 % de taux de succès, car la recherche s’exécute à chaque échec et doit être financée par les succès. En dessous de cette ligne, l’infrastructure est un centre de coûts déguisé en remise. Selon le cadrage même de l’article, cela laisse 20 à 30 % du trafic de production exclus du cache par construction. Les questions exclues ne sont pas sans importance. Elles ne se répètent pas, et la non-répétition est la seule propriété qu’aucune remise ne peut valoriser.
Un cache ne récompense pas une bonne question ; il récompense la même question.
Amazon a construit le routage qu’impose cette arithmétique, puis l’a décrit publiquement. Ses ingénieurs, en expliquant comment Rufus était servi, ont divisé le trafic en deux : « quelle est la puissance de cette perceuse ? » part vers des modèles plus petits et plus rapides, tandis que planifier un voyage de camping ou choisir un cadeau déclenche un raisonnement plus poussé et un dialogue multi-tours. La mise en cache des prompts apparaît dans le même passage que l’appel d’outils en parallèle, classée sous la rubrique latence. L’assistant lui-même a été absorbé par Alexa en mai, comme nous le rapportions à l’époque, mais la divulgation technique a survécu au produit. C’est l’énoncé public le plus clair de la règle : la forme de la question détermine quel modèle y répond, et donc combien coûte la réponse.
Ce qui compte comme réutilisation est plus étroit que le mot ne le suggère. Un cadre de mise en cache publié sur arXiv en juillet et révisé ce mois-ci convertit les programmes de raisonnement en objets paramétrés, à partir du constat que de nombreuses requêtes « partagent des structures computationnelles similaires tout en différant par leurs variables » ; il annonce un gain de latence pouvant atteindre environ trois fois sur des ensembles de requêtes incluant le benchmark shopping WebShop. L’unité réutilisée, c’est la structure de la requête, avec les détails interchangés. ASOS a lancé son application Stylist dans ChatGPT en mai, et l’exemple de prompt donné dans sa propre annonce était « montre-moi des robes trapèze à motifs floraux pastel pour le printemps ». Couleur, motif, silhouette, saison : quatre variables et une recherche, un filtre de catalogue habillé en conversation de styling — et cela se met en cache à merveille.
La requête qui ne se décompose pas en variables est précisément celle que les clients disent vouloir. La propre enquête d’Asos, rapportée ici ce matin, a montré que les consommateurs britanniques demandent aux enseignes des conseils de style plutôt qu’un choix plus large. Le conseil est par nature irrépétable, puisqu’il se définit par la personne qui le demande. C’est aussi, sans surprise, la question par laquelle commencent la plupart des démos fournisseurs. La question impressionnante et la question coûteuse sont la même question.

Les contrats bâtis par-dessus tout cela masquent la variance plutôt que de la résoudre. Intercom facture 0,99 $ par conversation résolue et facture une seule fois, quel que soit le nombre de questions posées par le client à l’intérieur. C’est un prix fixe appliqué à une base de coûts qui varie selon le modèle qui répond et la longueur de sa réponse, ce qui fait de la marge du fournisseur un pari permanent sur le mix de requêtes. Amazon pouvait absorber ce pari à l’échelle de trois millions de tokens par minute pendant le Prime Day. Une enseigne de taille moyenne qui achète des résolutions à l’unité se trouve de l’autre côté de ce pari.
L’objection la plus solide est que le prefix caching se moque de ce que demande le client. Le system prompt, les définitions d’outils et le contexte catalogue précèdent chaque requête, si bien que la question de styling bénéficie de la même remise que la vérification de stock. Une enseigne convaincue que les questions difficiles convertissent mieux devrait accepter de les payer plus cher. Mais pour que l’objection tienne, la prime de conversion sur les questions irrépétables doit croître au même rythme que leur surcoût, chez chaque enseigne — pas seulement chez celle qui possède le plus grand catalogue et une régie publicitaire adossée à la réponse.
La remise s’arrête exactement là où s’arrête le préfixe partagé. La documentation d’Anthropic précise qu’un cache hit exige des segments identiques à 100 % jusqu’au point de rupture, et que la mise en cache n’a aucun effet sur la génération des tokens de sortie. Tout ce qui suit ce point est facturé au tarif plein : les produits récupérés, les contraintes énoncées par le client, et la réponse rédigée dans son intégralité — laquelle, sur la gamme de modèles actuelle d’Anthropic, coûte cinq fois le prix de l’entrée qui l’a produite. Un échange de styling sur mesure est la réponse la plus longue qu’un assistant écrira jamais. C’est aussi la seule partie de la transaction qu’aucun cache n’a jamais touchée.
Rien de tout cela ne rend la conversation de styling impossible. Cela en fait une ligne budgétaire que quelqu’un doit défendre, et, honnêtement chiffrée, elle relève du budget marketing plutôt que de l’automatisation du support — ce qui la place dans un budget différent, avec un taux de rentabilité différent. Les enseignes qui continueront à l’offrir seront celles qui l’auront décidé en connaissance de cause, chiffres à l’appui. Celles qui arrêteront ne l’annonceront pas. Si la ligne de coût reste sans défenseur, leurs assistants deviendront simplement de plus en plus doués pour répondre aux questions sur le catalogue, parce que c’est ce que le cache a toujours été fait pour financer.