KI-Code legte 45 Punkte bei der Syntax zu und null bei der Sicherheit. Der Handel hat ihn trotzdem in die Kasse verdrahtet.
Veracodes Spring-2026-Update beziffert die Sicherheits-Erfolgsquote für maschinell geschriebenen Code auf rund 55 Prozent – unverändert über zwei Jahre, in denen die syntaktische Korrektheit auf etwa 95 Prozent geklettert ist. Der Handel hat auf die Kurve gesetzt, die sich bewegt hat, und die Review-Schuld ist bei genau dem Code hängen geblieben, der Zahlungen und Kundendaten berührt.
Neritus Vale
Maschinell geschriebener Code ist deutlich besser darin geworden zu laufen – und keinen Deut besser darin, sicher zu sein. Veracodes Spring-2026-Update zur GenAI-Codesicherheit beziffert die Sicherheits-Erfolgsquote für KI-generierten Code auf rund 55 Prozent – genau dort, wo sie schon vor zwei Jahren und mehreren Modellgenerationen lag. Die Korrektheit hat sich im selben Zeitraum stark verbessert, die Sicherheit nicht, und der Grund ist simpel: Ein Compiler und eine Testsuite bewerten Korrektheit umsonst, aber einen vergleichbaren Prüfer für Sicherheit gibt es nicht. Der Handel hat auf die Kurve gesetzt, die sich bewegt hat. Commerce-Stacks, die in diesem Jahr generierte Integrationen hinzugefügt haben, tragen jetzt Review-Schulden, und diese Schulden sind ausgerechnet bei dem Code hängen geblieben, der Zahlungen und Kundendaten berührt.
Der Bruch in diesen Daten ist zunächst ein Messproblem, erst danach ein Modellproblem. Bei SQL-Injection und schwachen kryptografischen Algorithmen bestanden Veracodes Modelle 82 bis 86 Prozent der Aufgaben, weil diese Fehlerklassen eine lokale Signatur tragen, die ein Prüfwerkzeug benennen kann, ohne die Zeile zu verlassen, die es gerade liest. Erkennung ist überall dort billig, wo der Fehler in der Syntax sichtbar ist, die ihn enthält. Bei Cross-Site-Scripting und Log-Injection erzielten dieselben Modelle nur 13 bis 15 Prozent, weil diese Fehlerklassen davon abhängen, wohin die Daten anschließend wandern. Automatisierte Detektoren erben genau diese Grenze, und deshalb war der Scanner-Markt schon immer am stärksten bei den Klassen mit einer Form und am schwächsten bei den Klassen mit einem Kontext. Ein Tool kann beweisen, dass eine Abfrage parametrisiert ist; es kann nicht entscheiden, ob der Retouren-Service überhaupt eine Kundenadresse lesen darf, denn diese Regel steckt in einer geschäftlichen Richtlinie und wurde nie ins Repository geschrieben.
Niemand hat veröffentlicht, welchen Anteil des eigenen Codes im Handel ein Agent geschrieben hat, und schon diese Lücke ist Teil der Gefährdung. Die nächstliegende verfügbare Messung liefert AIDev, ein im Februar 2026 veröffentlichter Datensatz von Hao Li, Haoxiang Zhang und Ahmed E. Hassan, der 932.791 von Agenten verfasste Pull Requests aus fünf kommerziellen Coding-Agenten auf öffentlichem GitHub katalogisiert. Commerce-Code liegt überwiegend nicht in öffentlichen Repositories, weshalb ein Händler, der über die eigene Gefährdung nachdenkt, von einer Stichprobe extrapoliert, die genau diesen Code ausschließt. Kein Dashboard im Handel weist aus, welcher Anteil der Kasse von einem Agenten geschrieben wurde.
Die entscheidende Zahl ist nicht, wie oft ein Agent einen Fehler schreibt, sondern wie oft dieser Fehler das Review übersteht. Eine Studie vom Juli 2026 von A H M Nazmus Sakib, Dipayan Banik und Murtuza Jadliwala hat 16.112 von Agenten verfasste Dateiänderungen aus diesem Korpus durch einen LLM-Prüfer und eine manuelle Analyse laufen lassen und in 38,9 Prozent der Pull Requests einen Security Code Smell gefunden. Ein Smell ist kein bewiesener Exploit; er ist genau das Muster, für dessen Erkennung ein Reviewer da ist. Probleme bei der Supply-Chain-Integrität waren mit 82,3 Prozent aller erkannten Smells die größte Kategorie; fest codierte Zugangsdaten machten einen kleineren Anteil aus, standen aber für fast jeden Fall mit kritischem Schweregrad.
Von den tatsächlich geleakten Geheimnissen, die die Autoren bestätigten, hatten 81,1 Prozent sowohl das automatisierte als auch das menschliche Review durchlaufen, bevor die Änderung integriert wurde. Secret Scanning ist der ausgereifteste Detektor im kommerziellen Einsatz, über ein Jahrzehnt menschlicher Commit-Historie feinjustiert – und genau er hat hier versagt. In einem Commerce-Repository ist das fragliche Geheimnis ein Schlüssel für ein Zahlungsgateway, ein API-Token des Lagersystems oder eine Zugangsdatenkette für die Kundendatenbank.
Dieselbe Studie fand heraus, dass nicht Agenten, sondern menschliche Mitwirkende 67,6 Prozent der bestätigten Leaks eingebracht haben. Das liest sich wie eine Entlastung – ist es aber nicht. Das Versagen sitzt in der Review-Ebene, nicht bei der Autorenschaft, und das ist der teurere Ort, um es zu finden. Autorenschaft lässt sich per Richtlinie korrigieren; Review-Kapazität kauft man eine qualifizierte Person nach der anderen.
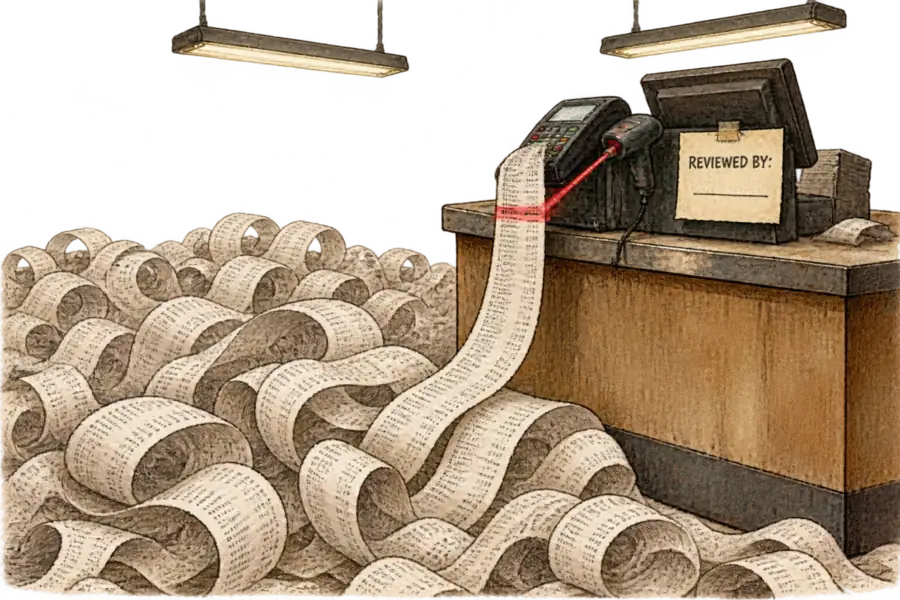
Der Handel ist eine der wenigen Branchen, in denen dieser Review-Schritt eine vertragliche Pflicht ist, und diese Pflicht nennt eine Person beim Namen. PCI DSS v4.0.1, veröffentlicht vom PCI Security Standards Council, verlangt, dass maßgeschneiderte und individuelle Software vor der Freigabe geprüft wird, und wo diese Prüfung manuell erfolgt, verlangt Anforderung 6.2.3.1, dass sie von jemand anderem als dem ursprünglichen Autor des Codes durchgeführt wird – von jemandem mit Kenntnissen in sicherer Programmierung, dazu mit Freigabe durch das Management. Die Kontrolle kauft Unabhängigkeit ein, und sie definiert diese Unabhängigkeit über die Autorenschaft. Schreibt ein Agent die Änderung und liest ein zweiter Agent aus derselben Modellfamilie sie gegen, übersteht das Artefakt das Review unbeschadet – die Unabhängigkeit aber nicht. Die knappe Ressource bei Retail-Integrationen war schon immer eher die Unterschrift als der Code; genau das sollte der Scanner eigentlich lesen.
Ein Händler kann die Prüfung bestehen und trotzdem niemanden haben, der den Diff gelesen hat.

Der stärkste Einwand lautet, dass die Erkennung auf derselben Kurve automatisiert wird wie die Generierung. Code-Augur, im Juni 2026 veröffentlicht von Zhengxiong Luo, Mehtab Zafar, Dylan Wolff und Abhik Roychoudhury, beginnt mit der Aussage, agentenbasierte Schwachstellenerkennung sei „ein Wendepunkt für die Softwaresicherheit“, stellt fest, dass so gefundene Fehler „jahrelang verborgen geblieben“ seien, und berichtet von 22 neuen Schwachstellen in zentralen Open-Source-Projekten. Skaliert die Erkennung im gleichen Tempo wie das Schreiben, wäre die Schuld nur vorübergehend, und die bindende Grenze läge wieder beim Code. Damit das gilt, müsste der Detektor allerdings wissen, wofür der Code eigentlich gedacht war. Code-Augurs eigenes Design räumt genau das ein: Es funktioniert, indem es den Agenten zwingt, seine stillschweigenden Annahmen als Sicherheits-Assertions im Quellcode festzuschreiben, und diese dann mit einem gesteuerten Fuzzer zu widerlegen versucht. Ein Fuzzer kann eine Assertion über die Eingaben eines Parsers auslösen; er hat keine Möglichkeit, eine Assertion darüber auszulösen, welcher Dienst berechtigt ist, die gespeicherte Adresse eines Kunden zu lesen.
Der Handel hat außerdem gerade erst vorgeführt bekommen, was passiert, nachdem eine Erkennung erfolgreich war. CVE-2025-54236, die als SessionReaper bekannte Session-Übernahme-Schwachstelle in Adobe Commerce, wurde im August 2025 entdeckt und im darauffolgenden September gepatcht und veröffentlicht. Sansec verzeichnete bis zum 23. Oktober – dem Tag nach Beginn der massenhaften Ausnutzung – 38 Prozent gepatchter Magento-Shops. In dieser Abfolge hatte die Erkennung ihre Aufgabe erfüllt, doch die Population der Händler konnte das Ergebnis nicht absorbieren. Bis zum 26. Oktober schätzte die Firma, dass 16 bis 18 Prozent aller Magento-Shops eine oder mehrere eingeschleuste Backdoors trugen. Einen schnelleren Autor in eine Population mit dieser Aufräumquote einzufügen, entfacht kein Wettrennen zwischen Generierung und Erkennung – es verlängert nur die Warteschlange.
Die Entscheidung, vor der jeder Händler steht, betrifft die Frage, welche Hälfte der Pipeline personell aufgestockt wird. Generierungskapazität lässt sich pro Arbeitsplatz zukaufen, Review-Kapazität nicht – wodurch die billige Hälfte wie Fortschritt aussieht und die teure wie Reibung. Kommen generierte Integrationen weiterhin im aktuellen Tempo hinzu, während die Zahl der Menschen, die qualifiziert genug sind, um Zahlungscode zu lesen, konstant bleibt, wird sich das Defizit nicht als Ausfall ankündigen. Es wird sich zeigen als ein Händler, der nicht sagen kann, wer den Code gelesen hat, der die Kartennummer berührt – und der die Antwort aus dem Forschungsblog eines anderen erfährt. Für Syntax gibt es einen automatischen Prüfer. Für Sicherheit gibt es einen Menschen, und der Handel hat eingekauft, als käme dieser Mensch umsonst.